Maintenance informatique quotidienne : routines, contrôle réseau et support pour booster votre efficacité en entreprise
Quand les outils numériques ralentissent, la production suit la même trajectoire. La maintenance informatique quotidienne évite que de petits écarts deviennent des interruptions coûteuses. Elle organise la prévention, accélère la reprise et rend le support plus prévisible pour les équipes.
Dans cet article, vous trouverez une méthode opérationnelle pour piloter le parc, la sécurité et le support au quotidien. Les routines d’exploitation présentées s’adaptent à une PME comme à une organisation multi-sites.
A lire aussi : Gestion du temps pour freelances web : une méthode simple pour reprendre le contrôle en 2026
En bref
- La maintenance informatique quotidienne combine prévention, correction et amélioration continue
- La supervision réseau et l’hygiène logicielle réduisent la latence et les interruptions
- Le support et la documentation diminuent les tickets répétitifs et accélèrent la résolution
- Les tests de sauvegarde valident la reprise, donc la continuité d’activité
Pourquoi la maintenance informatique change la performance au quotidien ?
La maintenance informatique quotidienne agit comme un système nerveux : elle repère tôt les dérives, corrige vite, puis formalise les apprentissages. En réduisant les temps d’arrêt et les incidents récurrents, elle protège la productivité. Elle améliore aussi l’expérience interne, car les réponses deviennent cohérentes et mesurables.
A voir aussi : Gestion du temps pour freelances web : une méthode simple pour reprendre le contrôle en 2026
En 2024, des enquêtes IT ont montré que les interruptions pénalisent fortement les processus métiers, notamment via la perte de temps. La démarche la plus rentable commence par des routines planifiées, puis par la mesure de l’impact sur le terrain. La continuité n’est pas un objectif abstrait, elle se pilote chaque semaine.
- Définir un périmètre clair : postes, serveurs, réseau, identité, applicatifs métiers
- Contrôler les indicateurs : latence, saturation disque, disponibilité applicative
- Travailler par cycles : analyse, correction, vérification, documentation
| Composant | Risque en cas de dérive | Routine conseillée |
|---|---|---|
| Stockage | Blocage applicatif, pertes de données | Seuils d’alerte + contrôles mensuels |
| Réseau | Latence, déconnexions, erreurs applicatives | Supervision temps réel + revue hebdomadaire |
| Mises à jour | Exposition aux vulnérabilités, instabilités | Tests en environnement contrôlé puis déploiement planifié |
| Support | Tickets répétitifs, saturation du helpdesk | Base de connaissances + priorisation par impact |
Quels gestes de maintenance préventive réduireont vos arrêts ?
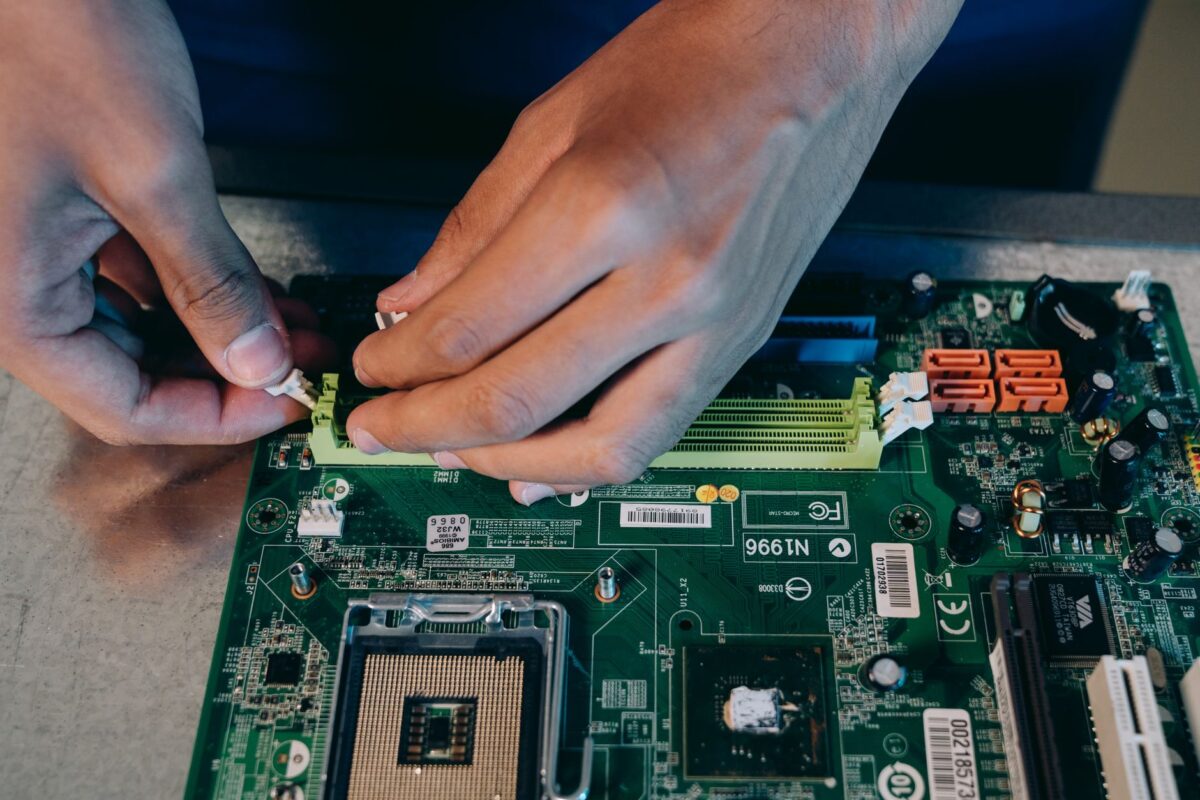
La maintenance préventive consiste à agir avant la panne, avec des contrôles réguliers et des seuils d’alerte. Elle cible le stockage, l’identité, les dépendances réseau et les journaux d’événements. Les actions sont documentées, ce qui limite les retours arrière et améliore la régularité des interventions.
Un bon modèle s’appuie sur des cycles. La revue mensuelle valide les tendances, la revue trimestrielle sécurise les accès, et les fenêtres planifiées réduisent les impacts métiers. Les sauvegardes doivent être restaurées au moins une fois par période définie, sinon l’entreprise ne sait pas réellement récupérer.
Exemple concret : une équipe IT chez Decathlon gère ses environnements à grande échelle avec des procédures d’exploitation et de contrôle. L’intérêt n’est pas la taille, mais la discipline de cycle : vérification, preuve, puis ajustement des paramètres. Ce type de démarche réduit la variabilité des résultats.
À l’échelle PME, l’approche est similaire. Une PME utilisant Microsoft 365 et Windows Server peut standardiser les rapports d’état, puis prioriser les correctifs critiques. La valeur se mesure ensuite via la baisse des incidents liés aux mises à jour et aux capacités de stockage.
La sécurité opérationnelle et la disponibilité reposent sur des contrôles répétés, vérifiés, et sur des décisions basées sur des données.
- Vérifier l’espace disque et les performances avant saturation, avec seuils à 80 % et 90 %
- Lire les journaux d’événements pour repérer les signaux faibles, puis tracer chaque correction
- Contrôler la conformité des configurations, notamment le durcissement et les droits d’accès
Que faire en maintenance corrective pour limiter la récurrence des incidents ?
La maintenance corrective rétablit le service, mais la performance vient de l’analyse causale. Chaque incident doit produire un résumé structuré : périmètre, impacts, chronologie, actions et résultat. Cette méthode réduit la répétition, car elle transforme les retours d’expérience en améliorations concrètes.
Sur le terrain, la différence se joue en trois étapes. D’abord, isoler rapidement la cause probable. Ensuite, appliquer une correction validée, puis vérifier la stabilité. Enfin, intégrer une prévention, comme une modification de configuration ou un correctif testé.
Un incident réseau répété doit déclencher une recherche plus large. Si des utilisateurs d’un même site subissent des coupures, la cause peut venir d’un switch instable, d’un câblage dégradé, ou d’une dérive fournisseur. L’entreprise gagne du temps en traitant le problème par corrélation, pas seulement par tickets individuels.
Les procédures de communication jouent aussi. Une communication datée, factuelle et limitée à l’essentiel réduit l’incertitude. Le support agit alors comme un coordinateur, et non comme un simple guichet de statut.
| Phase | Sortie attendue | Exemple concret |
|---|---|---|
| Diagnostic | Hypothèses priorisées | Analyse des logs Active Directory et de la latence réseau |
| Correction | Changement validé | Relance de service + rollback si la stabilité se dégrade |
| Vérification | Preuve de retour à l’état normal | Tests applicatifs + contrôle des ressources CPU et RAM |
| Prévention | Action durable | Mise à jour en fenêtre planifiée ou remplacement du composant |
La supervision réseau suffit-elle pour garantir des performances stables ?
La supervision réseau est un socle, mais elle devient réellement efficace lorsqu’elle se connecte aux causes. En 2024, les cadres de cybersécurité insistent sur la visibilité continue et sur la réduction du temps de détection. La supervision doit donc couvrir la latence, la perte de paquets et les erreurs, avec des seuils actionnables.
Pour éviter les angles morts, la supervision doit aussi intégrer le matériel et les usages. Un point d’accès Wi-Fi vieillissant peut créer des ralentissements intermittents. Une prise de décision fondée sur des métriques réseau évite les correctifs “à l’aveugle”.
- Mesurer la latence et la perte de paquets, puis relier les métriques aux sites et VLAN concernés
- Suivre l’état des équipements : température, erreurs interface, charge CPU et mémoire
- Corréler supervision et support : les tickets fréquents indiquent souvent des dérives cachées
- Planifier le cycle de remplacement, avec une matrice âge et criticité
Comparaison utile : une équipe qui supervise sans seuils actionnables collecte des alertes, mais n’en tire pas de décisions. Une équipe qui fixe des seuils et des actions recommandées réduit les temps de réaction. La différence se voit en baisse du volume de tickets et en réduction des incidents de même nature.
Pour la partie outil, Centreon et Zabbix sont utilisés dans de nombreux environnements pour la supervision. Les résultats dépendent surtout de la qualité des règles, des dashboards et de la discipline de traitement des alertes.
Comment structurer un support technique qui accélère réellement la maintenance ?
Le support technique transforme la maintenance informatique quotidienne en service fiable, surtout lorsque la priorisation est claire. Un bon fonctionnement repose sur un processus de gestion des incidents cohérent : triage, qualification, résolution, puis synthèse. Le helpdesk devient alors un canal de pilotage, pas seulement un outil de ticketing.
En 2023, les recommandations IT de ITIL ont continué d’orienter la création de parcours et de responsabilités. L’objectif est de standardiser les réponses, de réduire les demandes répétitives et d’améliorer les délais sur les incidents à fort impact. La base de connaissances doit être maintenue, pas figée.
- Classer les tickets par impact métier et nombre d’utilisateurs affectés
- Documenter les étapes de diagnostic dans une base de connaissances interne
- Garder un historique : cause probable, correction, résultat et prévention
- Mesurer : délai de prise en charge, temps de résolution, récurrence
| Problème type | Symptôme observé | Réponse support efficace |
|---|---|---|
| Accès applicatif | Erreur d’authentification | Vérifier droits, synchronisation identité, puis logs applicatifs |
| Connexion réseau | Déconnexions Wi-Fi | Comparer sites et points d’accès, puis contrôler configuration radio |
| Stockage | Poste lent, avertissements disque | Nettoyage encadré, contrôle quotas, puis extension planifiée |
| Mise à jour | Instabilité après correctif | Test préalable sur groupe pilote, puis rollback si nécessaire |
Erreurs fréquentes à éviter pour une maintenance informatique performante
Les échecs viennent rarement d’un manque d’outils. Ils proviennent d’une méthode incomplète, surtout lorsque la maintenance informatique quotidienne manque de règles et de preuve. La première erreur consiste à ignorer les signaux faibles, comme les disques proches de la saturation ou les logs récurrents.
La deuxième erreur est l’absence de responsabilité explicite. Un incident non qualifié prend du temps, car personne ne sait quoi vérifier en premier. La troisième erreur est la non-documentation, qui empêche l’entreprise d’apprendre et de réduire la récurrence.
- Traiter chaque ticket sans corréler par site, équipement ou application concernée
- Déployer des correctifs sans fenêtre ni validation sur un périmètre pilote
- Programmer des sauvegardes sans test de restauration, donc sans garantie réelle de reprise
- Remettre en service après correction sans vérifier la stabilité applicative et système
Pour structurer les bonnes pratiques, une partie du travail est organisationnelle. Un plan de maintenance doit préciser les fréquences, les seuils d’escalade et les preuves attendues. Cette discipline évite les “interventions improvisées” qui coûtent du temps à toutes les équipes.
Comment bâtir un plan de maintenance informatique adapté à votre organisation ?
Un plan solide relie les contraintes métier aux capacités de l’équipe IT. Il commence par un inventaire opérationnel : parc, configurations réseau, dépendances applicatives et stratégie de sauvegarde. Ensuite, il fixe des cycles : quotidien, hebdomadaire, mensuel, trimestriel. La maintenance informatique quotidienne prend ainsi sa place dans un cadre global.
La phase suivante intègre des scénarios de test. Simuler une panne de serveur, vérifier les procédures de reprise et tester la restauration sécurise la continuité. Le plan devient alors un outil d’anticipation et non un document administratif.
| Rythme | Activités clés | Preuves à conserver |
|---|---|---|
| Quotidien | Vérification alertes, contrôle disponibilité outils critiques | Journal de supervision + synthèse incidents |
| Hebdomadaire | Revue journaux, capacité stockage, état réseau | Rapports d’état et actions correctives |
| Mensuel | Contrôle droits, santé systèmes, backlog mises à jour | Résultats contrôles + conformité |
| Trimestriel | Tests restauration, exercices reprise, audits parc | Procès-verbaux tests + écarts traités |
Exemple : un groupe régional avec 5 sites peut prioriser la disponibilité du VPN et de l’ERP. Les contrôles mensuels ciblent la bande passante, les comptes utilisateurs et l’espace disque. Les tests de restauration valident la capacité à reprendre après sinistre, y compris en cas de corruption logique.
Pour renforcer la maturité, les équipes peuvent s’aligner sur des référentiels reconnus, comme ISO/IEC 27001 pour la sécurité, et ITIL 4 pour la gestion des services. L’objectif reste le même : rendre la maintenance mesurable, reproductible et améliorable.
Quelles compétences renforcer pour améliorer maintenance et support ?
La performance dépend aussi des compétences. La maintenance informatique quotidienne nécessite des savoir-faire en diagnostic système, analyse réseau et gestion des identités. Une équipe formée limite les hypothèses inutiles et réduit la durée de résolution. La formation continue aide aussi à intégrer les évolutions de sécurité et les nouveaux comportements applicatifs.
Un plan de montée en compétence peut inclure des parcours sur les journaux, les bonnes pratiques de déploiement et les méthodes de post-mortem. Cette approche évite les “solutions de circonstance” et augmente la cohérence des décisions. Elle favorise aussi la communication technique, essentielle pendant un incident.
- Former au diagnostic : logs, métriques et corrélation d’événements
- Développer la maîtrise des changements : fenêtres, rollback et validation
- Renforcer la sécurité opérationnelle : durcissement, contrôle accès, gestion vulnérabilités
- Standardiser la documentation : templates d’incident et base de connaissances
Références utiles pour cadrer votre démarche
Pour aligner la maintenance avec des pratiques éprouvées, appuyez-vous sur des référentiels reconnus. Les sources ci-dessous apportent un cadre méthodique pour la gestion des incidents, la sécurité et la continuité.
Source 1 : NIST, “Security and Privacy Controls for Information Systems and Organizations (SP 800-53 Rev. 5)”, mise à jour publiée en 2020, complétée par des conseils d’application régulièrement actualisés. Source 2 : ENISA, “Threat Landscape” et analyses récentes publiées entre 2023 et 2024, utiles pour prioriser les contrôles liés aux vulnérabilités. Source 3 : ITIL 4, pratiques de gestion des services et gestion des événements, dernière consolidation éditoriale en 2019 et mise en œuvre par de nombreux organismes depuis.
Quelle est la différence entre maintenance préventive et corrective ?
La maintenance préventive réduit le risque via des contrôles programmés, des mises à jour testées et des seuils d’alerte. La maintenance corrective intervient après un incident pour rétablir le service, puis analyse la cause afin de limiter la récurrence.
Quels indicateurs suivre pour piloter la maintenance informatique quotidienne ?
Les indicateurs essentiels sont la disponibilité applicative, le temps de prise en charge, le temps moyen de résolution et le taux de récurrence. Pour le réseau, ajoutez la latence et la perte de paquets. Ces métriques relient l’IT à l’impact métier.
À quelle fréquence tester les sauvegardes en entreprise ?
Le test dépend de la criticité et des contraintes réglementaires, mais une période courte est généralement attendue. Une restauration testée apporte une preuve de reprise réelle. Sans test, la sauvegarde reste une hypothèse non vérifiée.
Comment prioriser les tickets quand tout semble urgent ?
La priorisation doit combiner l’impact métier, le nombre d’utilisateurs affectés et la criticité de l’application. Un modèle simple classe d’abord les incidents bloquants, puis les incidents dégradants, puis les demandes de configuration. La règle réduit les délais.
Quels outils peuvent aider sans complexifier la maintenance ?
Des outils de supervision comme Zabbix ou Centreon aident à collecter les métriques. Pour le support, un helpdesk avec templates et base de connaissances réduit les erreurs. L’essentiel reste les règles de traitement et la documentation.
Si vous voulez renforcer l’efficacité en entreprise avec une maintenance informatique quotidienne mieux maîtrisée, commencez par un inventaire, puis des cycles de contrôle et des seuils actionnables. Planifiez un premier mois, mesurez vos temps d’arrêt, et ajustez selon les résultats terrain.